
Wir haben Grund zu feiern! Erster Platz in der Vektorsuche bei der SISAP 2026 Indexing Challenge
Wir haben an der diesjährigen SISAP Indexing Challenge teilgenommen, einem offenen Wettbewerb für Ähnlichkeitssuche. Unser Index erreichte den ersten Platz in der Suchaufgabe mit 26.743 Anfragen pro Sekunde und den dritten Platz in der Bewertung der Indexerstellung.

Suche ist der Teil der vviinn Plattform, auf dem alles andere aufbaut. Daher ist die Arbeit am zugrundeliegenden Index auch nie abgeschlossen. Wir suchen ständig nach Wegen, um Antwortzeiten zu beschleunigen, bei schwierigeren Daten präzise zu bleiben und stabil zu arbeiten, während sich ein Katalog im Hintergrund ändert.
Ein Teil dieser Arbeit geschieht mit Kundendaten. Der Rest findet im offenen Austausch mit der Forschungsgemeinschaft statt, die an denselben Problemen arbeitet. Diese Gemeinschaft hat einen Treffpunkt: SISAP, die Internationale Konferenz für Ähnlichkeitssuche und -anwendungen, die dieses Fachgebiet seit neunzehn Jahren zusammenbringt und im Oktober in Brno tagt.
Eine Konferenz zu einer einzige Frage
Die zentrale Frage ist leicht formuliert, aber schwer zu beantworten: Wie findet man in einer großen Sammlung von Einträgen zu einem gegebenen Element dasjenige, das ihm am ähnlichsten ist, ohne es mit allen anderen zu vergleichen?
Auf diese Weise findet ein Fotoarchiv Bilder, die sich ähneln, und ein Onlineshop findet Produkte, die zusammengehören. Es ist dieselbe Frage, die hinter jeder Vektordatenbank, jeder Empfehlungs-Engine und jedem Chatbot steht, der vor der Antwort etwas nachschlägt. Alles bei SISAP, von der Theorie bis hin zu den Systemen, die in Millisekunden antworten müssen, leitet sich davon ab.
Ein Großteil dessen, worauf die Branche heute setzt, hat in diesem Raum begonnen. Graph-Indizes dominieren die Vektorsuche, und die Entwicklung, die zu HNSW führte, dem heute am weitesten verbreiteten Ansatz , begann mit einem Paper, das Yury Malkov und Kollegen 2012 bei SISAP vorstellten. Er hielt die Keynote 2023 darüber, wie sich die Methode von dort aus verbreitete. Ein Jahr später kam die Keynote von Piotr Indyk vom MIT, der für das Locality-Sensitive Hashing mit dem Kanellakis Award ausgezeichnet wurde; der anderen klassischen Antwort auf dieselbe Frage. Und die Menschen, die all dies im großen Maßstab betreiben müssen, bringen ihre Erkenntnisse zurück: Sanjiv Kumar, Google Fellow und VP bei Google Research, war im selben Programm wie das auch Search-Team von Facebook in einem früheren Jahr.
Die Indexing Challenge
Seit 2023 werden auf der Konferenz Indizes nicht nur diskutiert, sondern auch gemessen. Die Indexing Challenge testet die Systeme von Forschungsgruppen und Unternehmen mit denselben Daten unter identischen Bedingungen und veröffentlicht die Ergebnisse nebeneinander. Jede Aufgabe legt auch eine Mindestgenauigkeit fest, die ein Eintrag erreichen muss, bevor seine Zeit überhaupt gezählt wird, sodass niemand Geschwindigkeit durch schlechtere Antworten erkaufen kann.
Die Teilnehmer kommen von vier Kontinenten (Europa, Nord- und Südamerika sowie Asien) und aus beiden Bereichen des Feldes, Universitäten und Industrielaboren. Die Einreichung, die die Aufgabe zur Indexerstellung gewann, kam von der University of Maryland und Google Research: eine Universität und ein Industrielabor; die gleiche Mischung, die auch hinter unseren beiden Einreichungen steht.
Unser Index: Erster Platz in der Vektorsuchaufgabe
Task 2 speichert 256.921 Vektoren, die aus dem Inneren von Llama-3-8B entnommen wurden, und fragt für jede Anfrage die 30 gespeicherten Vektoren mit dem größten inneren Produkt ab. Der Index wird einmal erstellt und gibt dann nur noch Antworten, sodass nur die Antwortzeit bewertet wird.
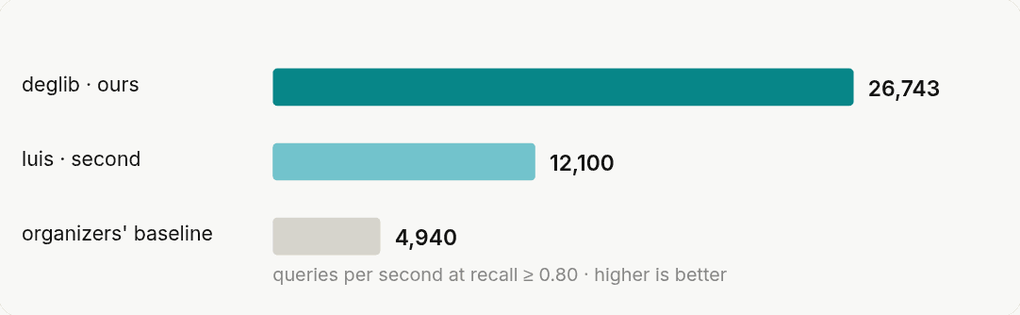
Wir erreichten den ersten Platz mit 26.743 Anfragen pro Sekunde – mehr als doppelt so schnell wie die zweitplatzierte Einreichung und 5,4-mal schneller als die Referenz der Organisatoren, in einem Feld von acht Teams.
Unser Index ordnet nach euklidischem Abstand statt nach innerem Produkt, und bei diesen unnormalisierten Vektoren weichen die beiden Ergebnisse voneinander ab. Die Lücke entstand dadurch, dass wir das Problem wieder in die Geometrie überführten, für die unser Index konzipiert ist, und die Vektoren anschließend für das Speichersystem anordneten – kurz gesagt: eine andere Geometrie und ein besseres Speicherlayout. (Wir werden einen eigenen Blogartikel mit einer detaillierten technischen Analyse der „Vector Search“-Aufgabe veröffentlichen.)
Unser Index: Dritter Platz bei der Index-Erstellung
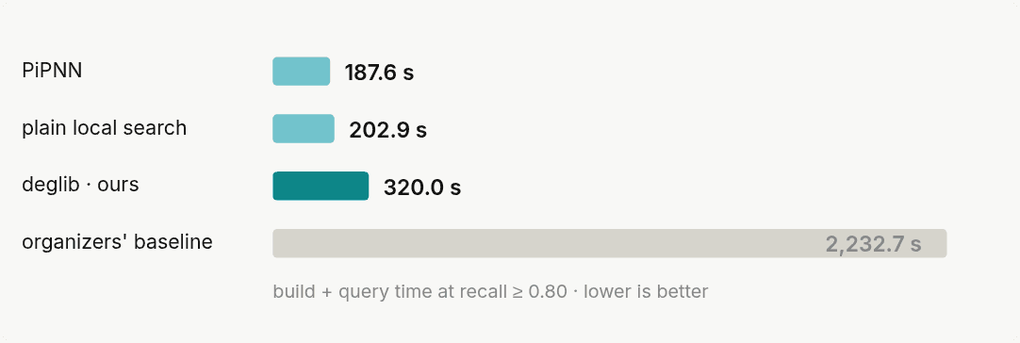
Task 1 sucht nach den 15 nächsten Nachbarn für jeden von 6,4 Millionen Wikipedia-Abschnitten. Hier fließt auch die Zeit für die Erstellung des Index in die Bewertung ein, was den größten Teil der Arbeit ausmacht. Wir wurden Dritter mit 320 Sekunden, siebenmal schneller als die Referenzwerte der Organisatoren, in einem Feld von vierzehn Teams, deren Zeiten sich im Bereich von 188 Sekunden bis über fünf Stunden bewegten.
Der Hebel bestand darin, eine einzelne Distanzberechnung während der Erstellung des Graphen um das Achtfache zu reduzieren und anschließend die dadurch verlorene Genauigkeit durch einen Reranking-Durchlauf wiederherzustellen. Das bedeutet konkret: zwei Bits pro Dimension, und erklärt, warum wir ein Reranking durchführen. (Wir werden auch einen eigenen Blog-Artikel mit dem tieferen technischen Einblick in die Indexierungsaufgabe veröffentlichen).
Fokus auf unsere Stärken: Hochdimensionale dichte Embeddings
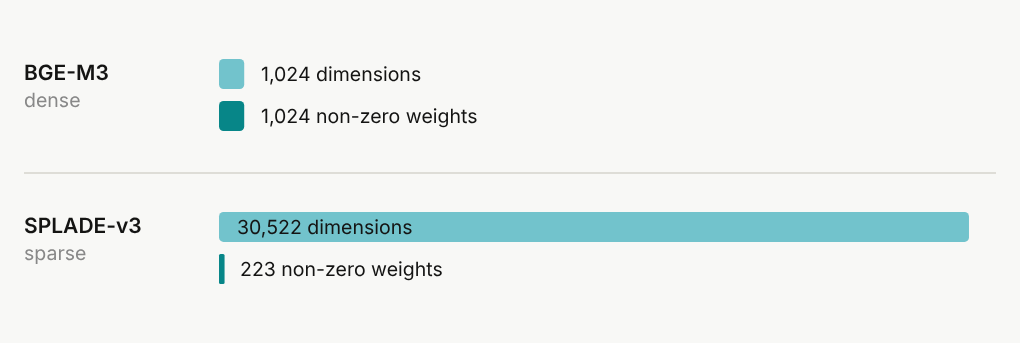
Die dritte Aufgabe durchsucht 2,68 Millionen Dokumente der Natural-Questions-Sammlung, die mit SPLADE-v3 in 30.522 dünnbesetzte Dimensionen kodiert sind, von denen etwa 223 in einem typischen Dokument ein Gewicht tragen. Für diese Asymmetrie sind invertierte Indizes gebaut: Sie führen eine kurze Liste pro Dimension und berühren niemals die leeren Zellen.
Ein Proximity-Graph spielt seinen Vorteil im gegenteiligen Fall aus, wenn jede Dimension ein Signal trägt, wie bei den dichten Embeddings, mit denen wir in den Commerce-Katalog-Umgebungen unserer Kunden arbeiten. Daher haben wir diese Aufgabe den Systemen überlassen, die dafür gebaut sind.
Unser Ziel: Die Grenzen der Suche für unsere Kunden verschieben
Die Ergebnisse sprechen für sich: Erster Platz in der Suchaufgabe und dritter Platz, wobei der Index ebenfalls aufgebaut werden muss gegen ein Feld von Spezialisten, jedes Ergebnis unter denselben Bedingungen produziert und nebeneinander veröffentlicht. Darauf sind wir stolz, ein großes Danekschön an das gesamte Team bei vviinn und an unsere Forschungspartner, die uns weiterhin an der Spitze des Feldes positionieren.
Was wir im Blick behalten, ist, wie wir an die Spitze gekommen sind: Aufgabe 2 war ein Geometrieproblem, das mit einer Transformation und einem Speicherlayout anstelle eines neuen Index gelöst wurde; Aufgabe 1 produzierte einen Quantisierungsschritt, der die Erstellung günstiger macht, genau bei den Kosten, die wachsen, wenn ein Katalog wächst; und das Auslassen der dritten Aufgabe war dieselbe Art von Entscheidung, nämlich den Aufwand dorthin zu lenken, wo die Daten unserer Kunden liegen.
Alle drei Punkte zusammen sorgen dafür, dass unsere Plattform schnell und erschwinglich bleibt, während Kataloge wachsen. Benchmarks sind ein fantastischer Beleg; aber der wahre Beweis sind die eigenen Daten der Kunden, wo die Frage nicht ist, wer an der Genauigkeitsschwelle der Challenge am schnellsten ist, sondern was die Kunden wahrnehmen.
Diese beiden Änderungen anhand unserer eigenen Embeddings und unserer eigenen Metriken zu messen, ist unser nächster Schritt und ein kommender Beitrag.
Literatur und Verweise
Unsere Einreichung: Hezel, Barthel, Schilling, Schall, Moelle and Jung, Fast and Efficient Approximate Nearest Neighbor Search for High-Dimensional LLM Embeddings (arXiv:2607.20957), mit der vollständigen Methode und allen Messungen (auf Englisch).
Unser code: Visual-Computing/sisap26-deglib, the submissions for both tasks.
Über die Challenge: SISAP 2026 Indexing Challenge, Aufgaben und Datensätze sowie die Rangliste mit den Ergebnissen aller Teams (auf Englisch).
Über den Index selbst: Unser früherer Blogartikel Dynamic Exploration Graph: Fast Search in Evolving Catalogs.
Über die Konferenz: SISAP 2026, the 19th International Conference on Similarity Search and Applications, Brno, 14–16 October 2026.
Verwandte Beiträge

Warum Suche mehr benötigt als Content Understanding
